ทีมสลับทราฟฟิกจาก Green กลับไป Blue แล้ว กราฟข้อผิดพลาดโดยรวมลดลง แต่ลูกค้าบางรายยังเปิดคำสั่งซื้อไม่ได้ ถ้าคุณอยู่ในทีม จะประกาศว่าระบบกลับมาปกติ หรือจะตรวจอะไรต่อ?
นี่คือเหตุการณ์สมมติที่ต่อจากบทความ Blue/Green Deployment บน AWS ในรอบก่อน ผมจะใช้มันชวนคิดว่าควรทำอย่างไรเมื่อผลของการแก้ปัญหาตรงกับที่คาดไว้เพียงบางส่วน กราฟที่ดีขึ้นบอกว่าบางอย่างฟื้นแล้ว ส่วนงานที่ลูกค้ายังทำไม่ได้ช่วยชี้ว่าควรมองตรงไหนต่อ บทความก่อนหน้าเรื่อง Blue/Green Deployment บน AWS
Mental model หรือแบบจำลองทางความคิด คือคำอธิบายอย่างย่อว่าระบบทำงานอย่างไร แบบจำลองที่ดีช่วยให้ทีมระบุได้ว่าคาดว่าจะเห็นอะไร และพร้อมเปลี่ยนคำอธิบายเมื่อหลักฐานชี้ไปอีกทาง สำหรับกรณีนี้ จุดเริ่มต้นคือแยกสองคำถามออกจากกัน ใครกำลังรับคำขอ และข้อมูลที่คำขอนั้นต้องใช้ยังอ่านได้หรือเปล่า?
ผมแยก วิธีตั้งหลัก ออกจาก แบบจำลองที่ใช้คิด วิธีตั้งหลักคือยอมบอกว่าเรื่องไหนยังไม่รู้ แยกสิ่งที่เห็นออกจากข้อสรุป และตกลงกันว่าอะไรจะทำให้เปลี่ยนใจ ส่วนแบบจำลองช่วยเลือกคำถาม ถ้าหลงทางระหว่างหลายระบบ ให้ทำแผนภาพเหตุและผล ถ้ามีหลายคำอธิบาย ให้หาหลักฐานที่แยกสมมติฐานได้ ถ้าต้องตัดสินใจก่อนปล่อยงาน ให้ถามว่าผลอะไรย้อนยากแล้วใช้ premortem ช่วยเลือกเรื่องที่ควรซ้อม
เลือกวิธีให้ตรงกับชนิดของปัญหา
ถ้าอยากรู้ว่าคำขอหนึ่งไปถึง Blue หรือ Green ทีมไล่ตรวจจากกฎของ Application Load Balancer (ALB) ไปถึงบันทึกของแอปได้ งานแบบนี้อาจยุ่งยากและต้องอาศัยคนที่รู้ระบบ แต่เมื่อมีหลักฐานครบก็ตรวจเส้นทางย้อนหลังได้ ในกรอบ Cynefin ของ Cynthia Kurtz และ Dave Snowden นี่ใกล้กับบริบทที่หาความสัมพันธ์ของเหตุและผลได้ด้วยการวิเคราะห์ หรือ knowable ในงานต้นฉบับ งานต้นฉบับของ Kurtz และ Snowden
คำถามว่าเหตุขัดข้องจะลามแค่ไหนอาจซับซ้อนกว่า ลูกค้าบางรายอาจกดซ้ำ ระบบอาจลองใหม่เอง และงานเบื้องหลังอาจทำให้ผลของการเปลี่ยนแปลงปรากฏช้ากว่าที่คิด เมื่อปัจจัยเหล่านี้ส่งผลต่อกัน ทีมอาจต้องทดลองในวงจำกัดแล้วสังเกตพฤติกรรมก่อนเลือกว่าจะทำอะไรต่อ กรอบ Cynefin เรียกวิธีนี้ว่า probe, sense, respond การรู้กฎ ALB ช่วยตอบคำถามแรก ส่วนผลที่เกิดกับลูกค้าต้องดูจากการทำงานทั้งเส้นทาง งานต้นฉบับของ Kurtz และ Snowden
วาดให้เห็นว่าอะไรเปลี่ยน อะไรยังค้างอยู่
เริ่มแผนภาพด้วยเส้นทางสองสาย สายหนึ่งตามคำขอจากลูกค้าผ่าน ALB ไปยังแอป อีกสายตามข้อมูลที่ Green เขียนลงฐานข้อมูลร่วม พอสลับกลับ คำขอใหม่ไปที่ Blue ขณะที่รายการที่ Green เคยเขียนยังอยู่ ถ้ารายการที่เปิดไม่ได้กระจุกตัวในช่วงที่ Green รับงาน ทีมมีเหตุผลให้ตรวจรูปแบบข้อมูลก่อน แต่ช่วงเวลาที่ตรงกันยังใช้ยืนยันสาเหตุไม่ได้
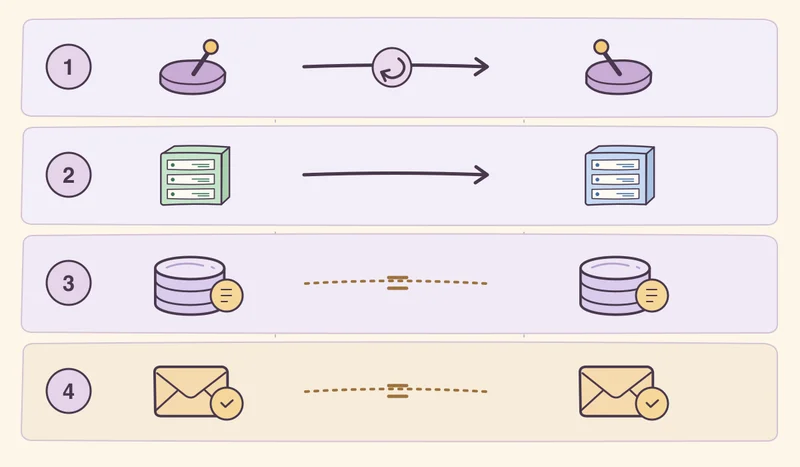
ลองเติมลูกศรอีกเส้นเมื่อมีหลักฐานว่าคำขอที่ล้มเหลวทำให้เกิดการลองใหม่ การลองใหม่อาจเพิ่มภาระให้แอปและฐานข้อมูลจนตอบช้าลง แล้วการตอบช้าก็กระตุ้นให้เกิดการลองใหม่อีก นี่เป็นตัวอย่างวงจรป้อนกลับที่ขยายปัญหา งานของ Donella Meadows ชวนให้ดูทั้งวงจรป้อนกลับและระยะเวลาที่ผลจะปรากฏ กราฟรวมที่ฟื้นเร็วอาจยังไม่บอกว่างานในคิวหมดแล้ว หรือว่าลูกค้ากลุ่มที่ได้รับผลกระทบกลับมาใช้งานได้ Leverage Points ของ Donella Meadows
ตั้งสมมติฐานที่แข่งกัน แล้วเลือกหลักฐานที่แยกได้
ผมจะเริ่มบันทึกสั้น ๆ ว่า “หลังสลับกลับ ลูกค้าบางรายยังเปิดคำสั่งซื้อไม่ได้” แล้วเขียนคำอธิบายที่เป็นไปได้มากกว่าหนึ่งข้อ กำกับแต่ละข้อด้วยสิ่งที่คาดว่าจะพบถ้าข้อนั้นจริง วิธีนี้ช่วยให้ทีมเลือกหลักฐานที่แยกคำอธิบายได้ แทนที่จะไล่ดูทุกกราฟพร้อมกัน แนวทางตรวจสอบปัญหาของ Google SRE
| สมมติฐาน | สิ่งที่ตรวจเพื่อแยกสาเหตุ |
|---|---|
| คำขอบางส่วนยังไปถึง Green | ไล่ request ID ของคำขอที่ล้มเหลวและตรวจว่าแอปเวอร์ชันไหนเป็นผู้ตอบ |
| Blue อ่านค่าที่ Green เขียนไม่เข้าใจ | ดูเวอร์ชันที่ตอบ เวลาเขียน และรูปแบบข้อมูลของคำสั่งซื้อที่เปิดได้เทียบกับที่เปิดไม่ได้ จากนั้นทดสอบตัวอย่างที่ตัดข้อมูลส่วนบุคคลแล้วบนระบบแยก |
| การลองใหม่หรือคิวงานทำให้บางคำขอตอบไม่ทัน | เทียบอัตราการลองใหม่ อายุงานในคิว และเวลาตอบในช่วงเดียวกัน แล้วแยกจากข้อผิดพลาดที่เกิดทันทีเมื่อแอปอ่านข้อมูล |
ถ้ารายการตัวอย่างที่ Green เขียนทำให้ Blue อ่านล้มเหลวบนระบบแยก แต่รายการรูปแบบเดิมอ่านได้ หลักฐานนี้หนุนสมมติฐานเรื่องรูปแบบข้อมูลในตัวอย่างที่ตรวจ ถ้าทั้งสองรายการอ่านได้ ให้ย้อนดูว่าระบบทดสอบต่างจากระบบจริงตรงไหน และยังมีคำอธิบายข้อใดที่ต้องตรวจต่อ ผลหนึ่งครั้งมีน้ำหนักตามขอบเขตที่ทดลอง
จำกัดผลกระทบก่อนทดลอง และซ้อมทางถอย
ก่อนแก้ระบบจริง ลองตรวจหลักฐานที่มีอยู่ก่อน ถ้ายังแยกสาเหตุไม่ได้ ให้ทำซ้ำด้วยคำสั่งซื้อทดสอบหนึ่งรายการในระบบแยก ปิดการส่งอีเมลและการชำระเงินจริง ตั้งเกณฑ์ว่าผลแบบไหนจะทำให้หยุดหรือเปลี่ยนสมมติฐาน หากกำลังมีความเสียหายเพิ่มขึ้น เช่น พบการตัดเงินซ้ำ ให้หยุดทางที่ก่อผลเสียตามขั้นตอนฉุกเฉิน แล้วค่อยตรวจสมมติฐานต่อ แนวทางตรวจสอบปัญหาของ Google SRE
ก่อนปล่อยรอบหน้า ลองทำ premortem ตามวิธีของ Gary Klein ให้ทีมสมมติว่าปล่อยไปแล้วและต้องย้อนกลับ แต่ลูกค้าบางรายยังใช้ระบบไม่ได้ ให้แต่ละคนเขียนเหตุผลก่อนคุยกัน แล้วเลือกความเสี่ยงที่ควรซ้อม ตัวอย่างนี้อาจได้โจทย์ให้ Green สร้างคำสั่งซื้อ จากนั้นให้ Blue เปิดรายการและทำงานต่อโดยไม่ตัดเงินหรือส่งข้อความซ้ำ Performing a Project Premortem ของ Gary Klein
เวลาซ้อมให้ถามด้วยว่าแต่ละการเปลี่ยนแปลงย้อนกลับได้แค่ไหน กฎ ALB สลับกลับได้ถ้า Blue ยังพร้อม ส่วนข้อมูลที่เขียนแล้วและงานที่ส่งออกไปต้องมีวิธีจัดการของตัวเอง ถ้าผลบางอย่างแก้คืนยาก ควรย้ายจุดทดลองให้มาก่อนขั้นนั้น หรือเก็บพฤติกรรมใหม่ไว้หลัง feature flag ระหว่างที่ยังต้องพึ่ง Blue แนวทาง AWS เรื่องข้อมูลและ schema ระหว่าง Blue/Green
ทบทวนว่าครั้งหน้าทีมจะเห็นปัญหาเร็วขึ้นอย่างไร
หลังเหตุการณ์ ให้บันทึกว่าตอนตัดสินใจทีมรู้อะไร ผลจริงต่างจากที่คาดตรงไหน และลูกค้ากลุ่มไหนยังติดอยู่ ใช้ลำดับเวลาช่วยคุยโดยไม่โยนความผิดให้คนที่กดสลับ หากพบว่าไม่มีใครเห็นอัตราเปิดคำสั่งซื้อล้มเหลวแยกตามกลุ่มรายการ ก็เลือกเพิ่มสัญญาณนั้นหรือเพิ่มการทดสอบก่อนปล่อย ระบุคนรับผิดชอบและเกณฑ์ที่จะใช้ยืนยันว่าการแก้ช่วยได้ แนวทางทบทวนเหตุการณ์ของ Google SRE
สำหรับปัญหาที่ทีมกำลังเจออยู่ ลองเขียนคำอธิบายที่เชื่อที่สุดหนึ่งข้อ แล้วตอบให้ได้ว่า ถ้าเห็นหลักฐานอะไร ทีมจะยอมเปลี่ยนใจ? คำตอบนั้นช่วยเลือกได้ว่าการตรวจครั้งถัดไปควรไปดูอะไร